أعِد أجهزتك القديمة إلى العمل.
يشغّل MirbadLLM نماذج الذكاء الاصطناعي الصغيرة والمتوسطة على جهاز الألعاب القديم والحاسوب المحمول وجهاز الماك التي تملكها أصلا، ويدير هذه الأجهزة كلها من مكان واحد، خلف عنوان واحد متوافق مع OpenAI.
Linux · Windows 11 · macOS (Apple Silicon) — vLLM · llama.cpp · MLX
يعمل على ما لديك
ذاكرة بطاقة الرسوميات، أو الذاكرة الموحّدة في الماك، هي التي تحدد حجم النموذج الذي يستطيع الجهاز تشغيله. هذه قواعد تقريبية لنماذج مضغوطة بدقة 4 بت:
جهاز ألعاب قديم
بطاقة NVIDIA بذاكرة 8 GB
7B–8BWindows 11 · llama.cppجهاز ألعاب ببطاقة أحدث
بطاقة NVIDIA بذاكرة 12–16 GB
~14BWindows 11 · llama.cppجهاز Linux
بطاقة NVIDIA بذاكرة 24 GB
~32BLinux · vLLM in Dockerماك أو ماك بوك
Apple Silicon بذاكرة 16–32 GB أو أكثر
7B–32BmacOS · llama.cpp / MLXDGX Spark
ذاكرة موحّدة 128 GB
largeLinux · vLLM in Dockerلا يدعم بعد بطاقات AMD ولا الأجهزة التي لا تحتوي على بطاقة رسوميات. وطول السياق ودرجة الضغط وعدد الطلبات المتوازية كلها تغيّر هذه الأرقام، لذلك يتحقق الوكيل من المساحة الفعلية قبل كل تشغيل.
كل جهاز يتحول إلى مشروع صغير قائم بذاته.
فلكل جهاز بيئة تشغيله وإعداداته ومنفذه الخاص، ولا يعرف أيٌّ منها بوجود الآخر؛ فينتهي بك الأمر إلى رعاية خمسة مشاريع صغيرة بدل استخدام أداة واحدة.
llama-server --port 8081 -ngl 99 …Error: address already in usemlx_lm.server --port 8080 …الجميع في الوقت نفسه.
حين يملك خادم النماذج مقعدا واحدا، ينتظر كل طلب دوره؛ فتقف ثلاثة وكلاء برمجة في VS Code، وسكربت زميلك، ومحادثة في البيت، في طابور واحد. أما MirbadLLM فيوزّع نماذجك على أجهزتك، والنماذج التي تعمل على vLLM تخدم طلبات كثيرة في اللحظة نفسها، فلا ينتظر أحد أحدا.
وكلاء متوازيون في VS Code
شغّل عدة وكلاء من Cline أو Roo Code أو Continue جنبا إلى جنب؛ إذ يذهب كل طلب إلى الجهاز الذي يخدم نموذجه، ولا يقف أحدها خلف الآخر.
فريق صغير، أو العائلة كلها
امنح كل شخص وكل أداة مفتاح API خاصا به. يستخدم الجميع العنوان نفسه في الوقت نفسه، وتُظهر لوحة النظرة العامة أي الأجهزة مشغول ولماذا.
النموذج المناسب لكل مهمة
النتائج الأفضل تأتي من عدم حشر كل شيء في جهاز واحد: نموذج برمجة أكبر على جهاز الألعاب، ونموذج محادثة سريع على الماك، والتضمينات على الحاسوب القديم.
قياس لا وعود. يقيس اختبار الأداء كل نموذج عند طلب واحد، و16 طلبا، وعند أقصى عدد من الطلبات المتوازية، على عتاده نفسه؛ فترى كيف يصمد حين يستخدمه الجميع.
ثلاث خطوات لكل جهاز
- 1
ثبّت الوكيل
انسخ أمر السطر الواحد من Nodes › Add node وشغّله على الحاسوب أو الماك، فيثبّت خدمة صغيرة.
- 2
وافق عليه من المتصفح
طابِق بصمة مفتاح الجهاز ثم وافق عليه، ومن بعدها يتصل الخادم الرئيسي به عبر TLS متبادل.
- 3
اختر نموذجا
اختره من Hugging Face، ويتحقق MirbadLLM من أنه يتسع في ذاكرة الجهاز قبل تشغيله، ويخبرك بالسبب إن لم يتسع.
عنوان واحد لكل نموذج على كل جهاز.
تحتفظ وكلاء البرمجة وتطبيقات المحادثة والسكربتات بعنوان أساسي واحد، وتختار النموذج باسمه، دون أن تحتاج إلى معرفة الجهاز الذي أجاب. ويمرّ عبره البث المباشر وإكمال المحادثات والنصوص والتضمينات.
وفي صفحة Connect إعدادات جاهزة للنسخ لأشهر الأدوات، ومنها ملف إعداد لـ VS Code.
from openai import OpenAI

client = OpenAI(
    base_url="http://mirbad.local:8080/v1",
    api_key="<your MirbadLLM API key>",
)
reply = client.chat.completions.create(
    model="qwen3-8b",  # served by the gaming PC
    messages=[{"role": "user", "content": "Hello"}],
)
كل ما يحتاجه أسطول صغير
كل المزايافحص الذاكرة قبل التشغيل
لكل نموذج ميزانية ذاكرة، ويُرفض التشغيل الذي لا يتسع، لكل بطاقة رسوميات، مع ذكر السبب.
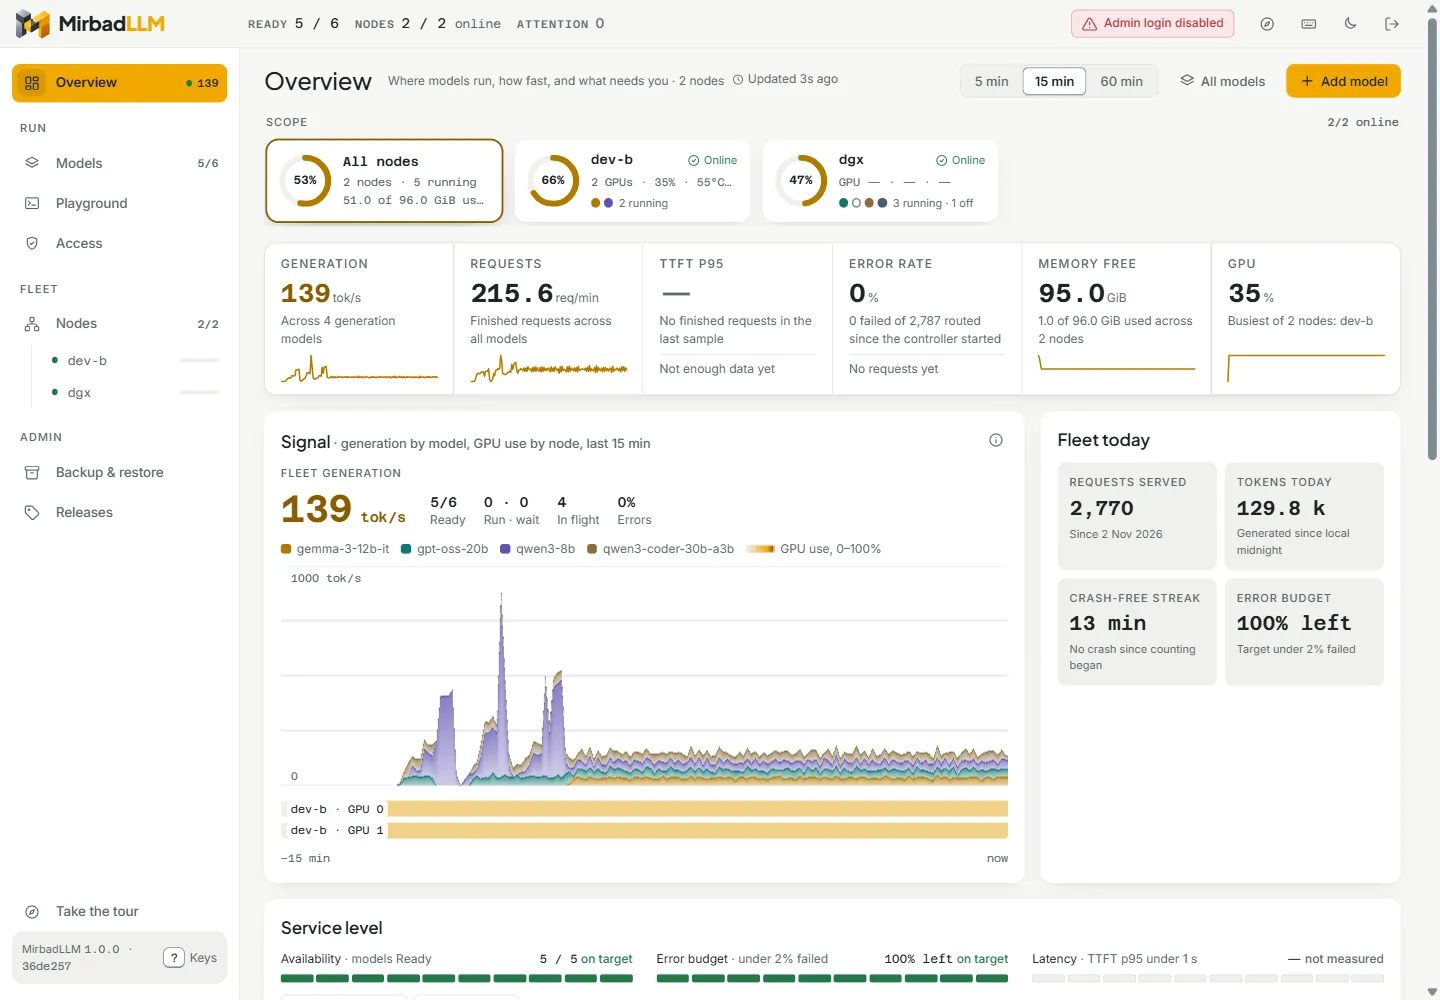
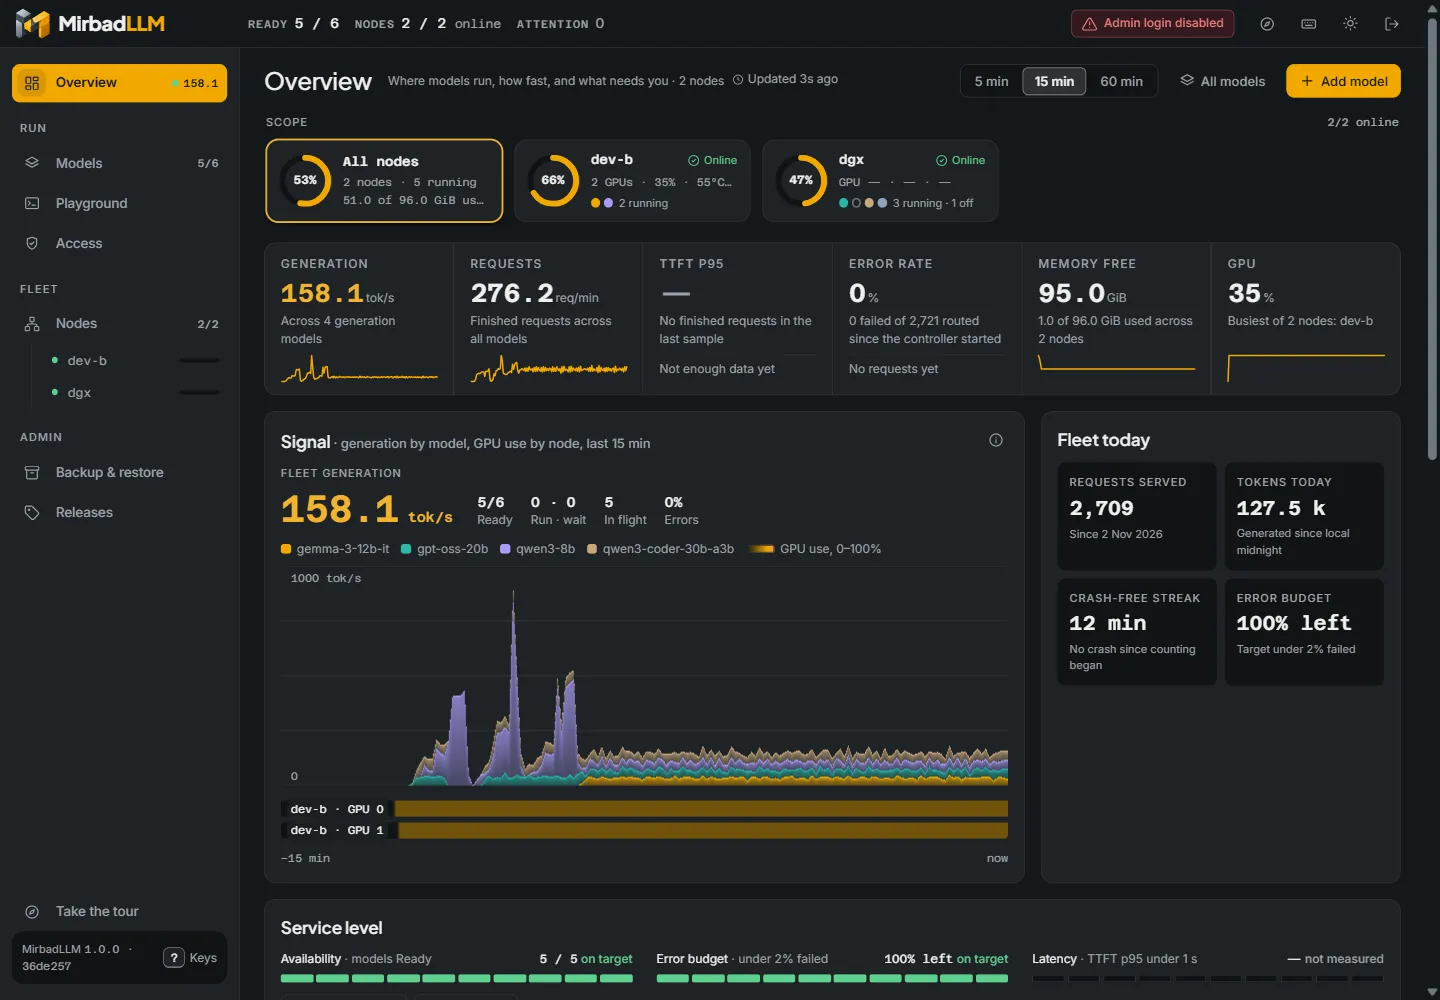
لوحة نظرة عامة مباشرة
ما الذي يعمل وأين، وسرعة توليد كل نموذج، ومقدار الذاكرة المتبقية في كل جهاز.
قياس الأداء والضبط
إعدادات أحمال جاهزة تقيس النموذج، وأداة ضبط تجرّب إعدادات vLLM وتسمّي الأفضل، ولا يتغير شيء حتى تضغط Apply.
مفاتيح API للأشخاص والأدوات
مفاتيح للعنوان ولمقاييس الأداء، ودخول إداري للواجهة، وإعدادات جاهزة للأدوات.
نسخ احتياطي مجدول
النماذج والإعدادات والمفاتيح والسجل، إلى مجلد أو مشاركة شبكية، مع استعادة تعرض كل تغيير قبل تنفيذه.
النماذج تعود من تلقاء نفسها
بعد إعادة التشغيل تعود النماذج التي كانت تعمل، واحدا تلو الآخر، أما النموذج الذي أوقفته فيبقى متوقفا.
الجولة في 100 ثانية
لماذا وُجد، وكيف تضيف جهازا ونموذجا، وماذا ترى حين يعملان. التعليق الصوتي والترجمة النصية بالإنجليزية.
جرّبه على حاسوبك المحمول أولا.
يعمل أسطول تجريبي بنماذج محاكاة على جهاز واحد دون حاجة إلى بطاقة رسوميات، ثم تنتقل بعده إلى أجهزتك الحقيقية.
$ git clone https://github.com/samykabu/MirbadLLM.git
$ cd MirbadLLM
$ tools/dev-multinode/start.sh --reset
# open http://127.0.0.1:5080/